Dijital Sınır Kapıları: Yurt Dışı Veri Aktarımı, Proxy Çözümleri ve Veri Egemenliği
Modern iş dünyasında küresel bulut yazılımlarını kullanmak kaçınılmaz hale gelmişken, KVKK Madde 9 kişisel verilerin yurt dışına çıkışını sıkı şartlara bağlar. Bu hukuki engeli aşmanın en zekice yolu, veriyi fiziksel olarak Türkiye’de tutarken buluta sadece anlamsız karşılıklarını göndermektir. Veri Koruma Proxy’leri, kullanıcı ile global bulut arasında bir “tampon bölge” kurarak, hassas verileri daha sınırdan geçmeden yakalar ve yerel bir kasaya kilitler.
Bu mimarinin kalbinde yer alan Tokenizasyon, gerçek veriyi (TCKN, isim vb.) alıp yerine matematiksel olarak deşifre edilemeyen rastgele bir “jeton” (token) üretme işlemidir. Şifrelemeden farklı olarak token, orijinal verinin hiçbir izini taşımaz. Amerika’daki bir sunucu hacklense bile, saldırganın eline geçen tek şey “oyun pulları” olur; gerçek veri ise Türkiye’deki kurumun kendi veri merkezinde güvendedir.
[Image comparing data encryption versus tokenization for cross-border data flows]
Bu yöntem, kurumlara hem dünyanın en gelişmiş SaaS çözümlerini kullanma esnekliği sağlar hem de Veri Egemenliğini (Data Sovereignty) koruyarak yasal ihlal risklerini sıfıra indirir. Şifreleme anahtarlarının çalınması veya kuantum bilgisayarlarca kırılması riski tokenizasyonda geçerli değildir; çünkü bulutta “kırılacak bir veri” yoktur. Siber güvenlik mimarisinde başarı, veriyi korurken onun işlevselliğini sınırların ötesine yasal bir zırhla taşıyabilmektir.
Kodlara İşlenen Mahremiyet: SDLC ve Tasarımdan İtibaren Gizlilik (Privacy by Design)
Siber güvenlik mimarisinde Tasarımdan İtibaren Gizlilik (Privacy by Design), mahremiyetin bir sistemin tasarım aşamasından itibaren varsayılan ve ayrılmaz bir fonksiyonu olması gerektiğini savunan proaktif bir felsefedir. Geleneksel “önce geliştir, sonra güvenliği ekle” yaklaşımının aksine PbD, gizliliği Yazılım Geliştirme Yaşam Döngüsü (SDLC)’nin her aşamasına (analiz, tasarım, kodlama, test, bakım) bir temel yapı taşı olarak yerleştirir.
Bu yaklaşımın temelinde Veri Minimizasyonu (sadece gerekli veriyi toplama), Varsayılan Gizlilik (Privacy by Default) ve Uçtan Uca Güvenlik ilkeleri yatar. Geliştirme sürecinde API’lerin aşırı veri çekmesini (over-fetching) engellemek, test ortamlarında gerçek veriler yerine Sentetik Veriler kullanmak ve “Unutulma Hakkı”nı daha kod seviyesinde veritabanı tetikleyicileriyle (triggers) kurgulamak bu felsefenin teknik yansımalarıdır.
[Image showing the difference between Privacy as an add-on versus Privacy as a core design element]
GDPR (Madde 25) ve KVKK nezdinde PbD, yasal bir zorunluluk ve “makul teknik tedbir” yükümlülüğünün kanıtıdır. Tasarım aşamasında göz ardı edilen bir gizlilik açığının ürün canlıya çıktıktan sonra düzeltilmesi, sistemi en baştan yazmak kadar maliyetli olabilir. Gerçek siber savunma, saldırganlar kapıya dayandığında değil; o kapının planları henüz kağıt üzerindeyken mimari bir zarafetle başlar.
Yapay Zeka Tabanlı Kötü Amaçlı Yazılım Üretimi: LLM’lerin Polimorfik Zararlı Kod Yazımında Kullanılmasının Tespit Güçlükleri
Generatif Yapay Zeka ve Büyük Dil Modelleri (LLM), siber saldırganlara saniyeler içinde benzersiz ve karmaşık zararlı kodlar üretme gücü vermiştir. Yapay Zeka Tabanlı Kötü Amaçlı Yazılım, her iterasyonda kendi kaynak kodunu, değişken isimlerini ve mantıksal akışını değiştiren Polimorfik bir yapıya sahiptir. Bu durum, bir dosyanın hash değerine dayanan geleneksel imza tabanlı antivirüs sistemlerinin koruma kalkanını tamamen baypas eder.
Saldırganlar, LLM’leri kullanarak otomatik Kod Karıştırma (Obfuscation) yapabilir ve zararlı yazılımın hedef sistemdeki güvenlik çözümlerini fark edip kendini gizlemesini (Evasion) sağlayabilir. Yapay zeka sadece kodu yazmakla kalmaz, aynı zamanda insan dilini kusursuz taklit ederek sosyal mühendislik saldırılarının inandırıcılığını da artırır. Bu teknoloji, karmaşık malware geliştirme maliyetlerini düşürürken, saldırı hacmini ve hızını insanüstü seviyelere taşır.
Bu yeni nesil tehditlere karşı korunmak için savunma tarafı da yapay zekayı kullanmak zorundadır. Kodun dış görünüşüne (statik) değil, ne yaptığına (dinamik/davranışsal) odaklanan Davranışsal Analiz, anomali tespit sistemleri ve gelişmiş Sandbox ortamları en etkili savunma hatlarıdır. Geleceğin güvenliği, sadece bilinen tehditleri durdurmak değil, yapay zeka tarafından sürekli evriltilen “bilinmeyen” davranışları öngörebilen adaptif sistemler üzerine inşa edilecektir.
Web Shell Kullanım Senaryoları ve Tespiti
Siber saldırganların web sunucuları üzerinde kalıcılık sağlamak ve uzaktan komut yürütmek için kullandıkları en etkili araçlardan biri Web Shell’dir. Web shell, web uygulamasının çalıştığı dilde (PHP, ASP, JSP vb.) yazılmış küçük bir betiktir ve genellikle dosya yükleme (upload) açıklarından veya uygulama zafiyetlerinden yararlanılarak sunucuya sızdırılır. Bir kez yerleştirildiğinde, saldırgana sunucu üzerinde dosya manipülasyonu, veritabanı erişimi ve iç ağ keşfi gibi geniş yetkiler sağlar.
Web shell tespiti, statik kontrollerin ötesinde davranışsal bir analiz gerektirir. Dosya Bütünlüğü İzleme (FIM) araçları ile web dizinindeki ani değişimlerin takibi, web sunucu loglarında (IIS, Apache, Nginx) görülen anormal HTTP istek kalıpları ve web sunucu prosesinin (w3wp.exe, apache2 vb.) aniden yeni süreçler (cmd.exe, /bin/sh) başlatması en güçlü tespit sinyalleridir. Sadece dosyayı silmek yeterli değildir; saldırganın içeri girdiği kök nedenin (vulnerability) bulunması ve temizlenmesi hayati önem taşır.
Savunma tarafında, En Az Yetki (Least Privilege) prensibi uygulanarak web sunucusunun yazma izinleri kısıtlanmalı, yüklenen dosyaların çalıştırılamayacağı izole dizinler kullanılmalı ve WAF (Web Uygulama Güvenlik Duvarı) ile şüpheli trafik desenleri filtrelenmelidir. Web shell’i bir “tekil dosya” olarak değil, bir “altyapı güvenliği sorunu” olarak ele alan kurumlar, saldırı yüzeyini daraltarak siber dayanıklılıklarını artırabilirler.
Vitrindeki Görünmez Zırh: WAF Mimarisi ve OSI Layer 7 Savunması
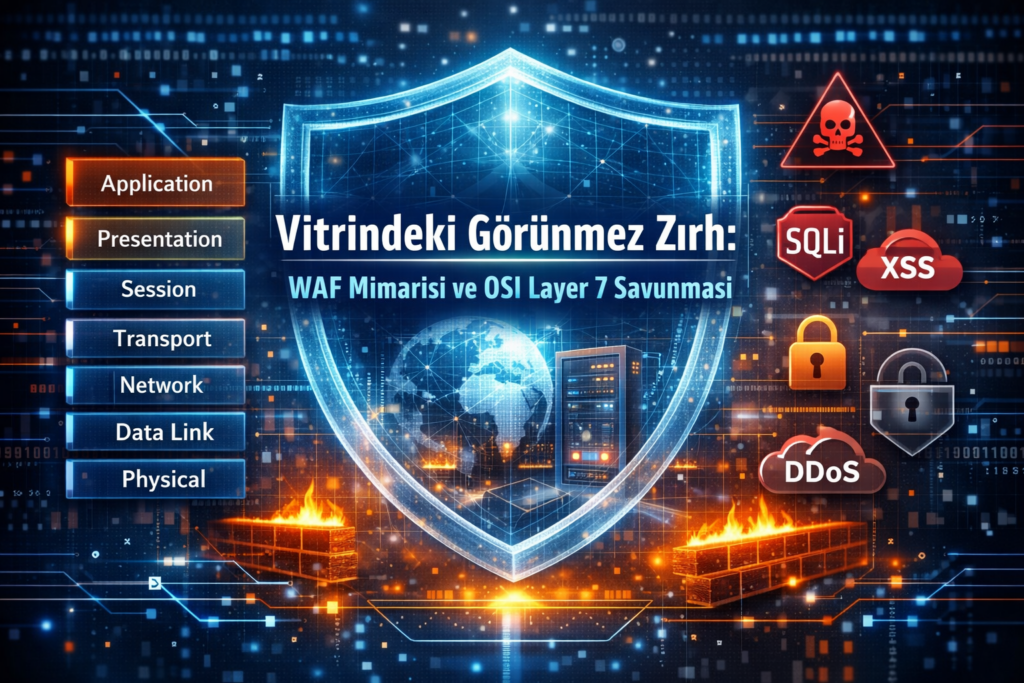
Siber güvenlik mimarisinde web uygulamalarını hedef alan karmaşık saldırılar, geleneksel ağ güvenlik duvarlarını kolaylıkla aşabilir. WAF (Web Uygulama Güvenlik Duvarı), OSI modelinin 7. katmanında (Uygulama Katmanı) çalışarak HTTP/HTTPS trafiğini mikroskobik düzeyde denetleyen bir “görünmez zırh” işlevi görür. WAF’ın temel görevi, OWASP Top 10 listesinde yer alan SQL Enjeksiyonu (SQLi) ve XSS gibi tehlikeli zafiyetlerin sömürülmesini, saldırı trafiği henüz sunucuya ulaşmadan engellemektir.
WAF, sadece bilinen saldırı imzalarıyla değil; modern versiyonlarında Yapay Zeka ve Davranışsal Analiz kullanarak “Sıfırıncı Gün” (Zero-Day) saldırılarını da tespit edebilir. Bu sistemler, normal kullanıcı davranışlarını öğrenerek botnet ve veri kazıma (scraping) gibi insanüstü hızdaki aktiviteleri anında anomali olarak işaretler. Ancak WAF yönetimi, “Yanlış Pozitif” (False Positive) riskini minimize etmek için sürekli ince ayar (Tuning) gerektiren hassas bir operasyonel süreçtir.
[Image illustrating the difference between a traditional Firewall (L3/L4) and a WAF (L7) in inspecting data packets]
Hukuki düzlemde PCI-DSS gibi küresel ödeme standartları ve KVKK rehberleri, internete açık portalların önünde bir WAF konumlandırılmasını “makul teknik tedbirlerin” bir parçası olarak zorunlu kılar. WAF, arka plandaki yazılım kodlarında bug olsa dahi, bu açıkların sömürülmesini engelleyen bir Sanal Yama (Virtual Patching) görevi görür. Dijital dünyada hayatta kalmak, trafiğin miktarından ziyade niyetini analiz edebilen bir kalkanın varlığına bağlıdır.
Veri Tabanı Aktivite İzleme (DAM): Kritik Tablolara Yapılan Sorguların Gerçek Zamanlı Denetimi ve KVKK Boyutu
Kurumsal verilerin kalbi olan veri tabanları, hem dış saldırganlar hem de yetkili iç kullanıcılar için en cazip hedeftir. Veri Tabanı Aktivite İzleme (DAM), veritabanı performansını etkilemeden (Ağ izleme veya Ajan tabanlı yöntemlerle) tüm SQL sorgularını gerçek zamanlı olarak yakalayan, analiz eden ve denetleyen bir teknolojidir. Standart loglama sistemlerinden farkı, sadece erişimi değil, sorgunun içeriğini ve “kaç satır veri çekildiği” gibi bağlamsal detayları da raporlamasıdır.
DAM sistemleri, Kural Tabanlı Algılama ve Davranışsal Analiz (UBA) yöntemlerini kullanarak “normal dışı” sorguları (örneğin toplu veri çekme veya mesai dışı erişim) anında tespit eder. Sanal Yama özelliği sayesinde veri tabanı güncellenmese dahi bilinen zafiyetlere karşı koruma sağlar. En kritik özelliklerinden biri olan Görevler Ayrılığı, veri tabanı yöneticilerinin (DBA) kendi hareketlerini gizlemesini engelleyerek tam şeffaflık sağlar.
KVKK Madde 12 uyarınca veri sorumluları, kişisel verilere yapılan her türlü erişimi kayıt altına almak ve güvenliğini sağlamakla yükümlüdür. Bir ihlal durumunda DAM, “kim, ne zaman, hangi veriye, hangi sorguyla ulaştı” sorusuna değiştirilemez bir kanıt sunar. Verinin nerede saklandığını bilmek kadar, o veriye nasıl “dokunulduğunu” da anlık olarak bilmek, modern siber savunmanın ve yasal uyumun temel taşıdır.
Veri Sınıflandırma Taksonomileri: “Gizli / Kişisel / Özel Nitelikli” Etiketleme Motorlarının Teknik Kurulumu ve KVKK Uyumu
Dijital dünyada veri güvenliğinin ilk adımı, verinin hassasiyet seviyesini tanımlamaktır. Veri Sınıflandırma Taksonomisi, kurumsal verileri “Kamuya Açık”, “Gizli” veya KVKK özelinde “Kişisel” ve “Özel Nitelikli” gibi kategorilere ayıran hiyerarşik bir sistemdir. Etiketleme Motorları ise bu kategorileri dokümanlara ve e-postalara kalıcı birer metadata olarak işleyerek, verinin yaşam döngüsü boyunca güvenlik politikalarıyla (şifreleme, erişim kısıtlama vb.) birlikte hareket etmesini sağlar.
Teknik kurulumda sınıflandırma; kullanıcıların manuel seçimi, Regex tabanlı kural setleri veya makine öğrenmesi algoritmalarıyla gerçekleştirilir. Bu etiketler, Veri Kaybı Önleme (DLP) sistemleri için birer tetikleyici görevi görür. Örneğin; üzerinde “Özel Nitelikli” etiketi olan bir dosya harici bir belleğe kopyalanmak istendiğinde, sistem metadata alanını okuyarak işlemi anında engeller. Bu, insan hatasından kaynaklanan veri sızıntılarına karşı en güçlü teknik bariyerdir.
KVKK Madde 12 nezdinde sınıflandırma, “makul teknik tedbir” yükümlülüğünün temelidir. Bir ihlal durumunda kurumun sızan verinin niteliğini bildiğini ve ona uygun koruma katmanları (etiket tabanlı şifreleme vb.) yerleştirdiğini kanıtlaması, idari para cezalarının hafifletilmesinde kritik rol oynar. Sınıflandırılamayan veri, yönetilemeyen ve dolayısıyla korunamayan veridir; gerçek koruma verinin “kimlik kartına” (etiketine) uygun bir kalkan inşa etmekle mümkündür.
Toksik Varlıklar ve Mimari Zarafet: Veri Minimizasyonu Prensipleri
Siber güvenlikte Veri Minimizasyonu, bir sistemi korumak için en temel ve etkili yöntemdir: “Toplamadığın veriyi korumak zorunda kalmazsın.” KVKK Madde 4 ve GDPR Madde 5 uyarınca, kişisel verilerin sadece işleme amacıyla sınırlı ve ölçülü tutulması yasal bir zorunluluktur. Teknik dünyada bu; gereksiz her bir veri alanının (TCKN, doğum tarihi, tam konum vb.) sistem için birer “Toksik Varlık” (Data Toxicity) olarak görülmesi anlamına gelir.
Minimizasyon süreci üç kritik katmanda yönetilir: Ön Yüzde (UI/UX) dinamik formlar ve koşullu mantık kullanılarak sadece ihtiyaç anında veri toplanır. API Katmanında, “Over-fetching” (aşırı veri çekme) probleminden kaçınmak için GraphQL gibi teknolojilerle sadece talep edilen alanlar transfer edilir. Veritabanı Katmanında ise, işi biten verilerin (Örn: teslimat sonrası anlık konum) TTL (Time to Live) indeksleri ile otomatik olarak imha edilmesi sağlanır.
Bu yaklaşımın en büyük kazanımı, bir veri ihlali durumunda siber saldırının yaratacağı “Patlama Yarıçapını” (Blast Radius) daraltmasıdır. Eğer sistemde kritik ve gereksiz veriler stoklanmamışsa, sistem ele geçirilse bile sızan bilginin değeri minimumda kalır. Veri güvenliğinin en mutlak ve en ekonomik hali, mükemmel bir mimariyle çıkarılacak hiçbir veri kalmayana kadar sistemi sadeleştirmektir.
Veri Kalitesi ve KVKK “Doğruluk İlkesi”: Yanlış Kişisel Verinin Sistemde Kalmasının Hukuki Sonuçları
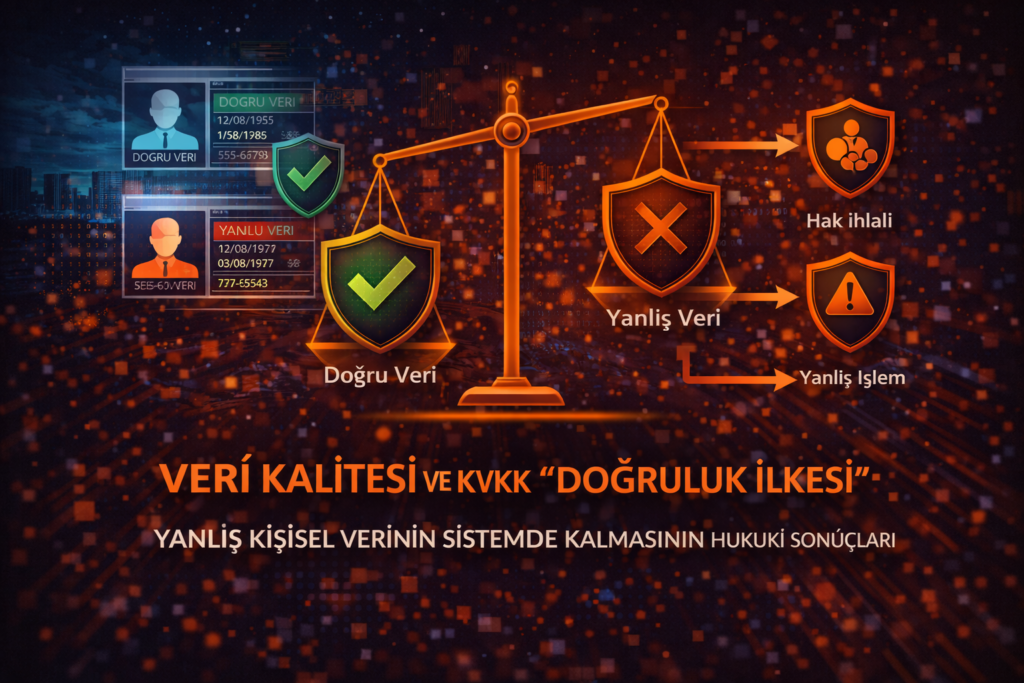
6698 Sayılı KVKK’nın 4. maddesi, kişisel verilerin işlenmesinde “doğru ve gerektiğinde güncel olma” ilkesini temel bir zorunluluk olarak belirler. Veri kalitesi; sadece verinin doğru formatta olması değil, gerçeği yansıtması ve zamanın gerisinde kalmamasıdır. Yanlış kişisel verilerin sistemlerde barındırılması, bireyler hakkında hatalı profilleme yapılmasına (kredi reddi, istihdam sorunları vb.) yol açarak kurumları ağır idari para cezaları ve tazminat davalarıyla karşı karşıya bırakır.
Teknik düzeyde veri doğruluğu; Input Validation (giriş kontrolü), Data Cleansing (veri temizleme) ve resmi servisler (MERNİS vb.) üzerinden yapılan Verification (doğrulama) süreçleriyle sağlanır. Master Data Management (MDM) sistemleri, kurum içindeki farklı departmanlarda dağılmış verileri tek bir “doğru kaynak” (Single Source of Truth) altında birleştirerek veri kirliliğini önler.
Hukuki açıdan, ilgili kişilerin (veri sahipleri) verilerini düzeltme hakkı saklıdır ve bu taleplerin 30 gün içinde yerine getirilmemesi doğrudan bir ihlal sebebidir. Kurumsal perspektifte doğruluk ilkesi, sadece yasal bir uyum değil, aynı zamanda itibar yönetimidir. Yanlış veri üzerine inşa edilen yapay zeka ve analiz modelleri, kurumu stratejik hatalara sürükler. Siber güvenlik ve mahremiyetin temeli, ancak saf ve doğru verilerle atılabilir.
Threat Hunting (Tehdit Avcılığı): Alarm Üretmeden Sessizce Bekleyen Saldırganları Hipotez Tabanlı Proaktif Arama
Geleneksel güvenlik sistemleri sadece bilinen imzalara ve alarm kurallarına yanıt verirken, Threat Hunting (Tehdit Avcılığı), otomatik sistemlerin radarından kaçan gizli ve sofistike saldırganları bulmak için yürütülen proaktif bir arama sürecidir. Bu disiplin, bir alarmın çalmasını beklemek yerine “Saldırgan şu an içeride olsaydı ne yapıyor olurdu?” sorusundan yola çıkarak kurulan Hipotez Tabanlı senaryolarla ağ ve uç nokta verilerini (logları) derinlemesine analiz eder.
Tehdit avcılığının temel amacı, saldırganın sistemde fark edilmeden geçirdiği süre olan Dwell Time’ı minimize etmektir. Avcılar; MITRE ATT&CK matrisindeki teknikleri, güncel tehdit istihbaratını ve istatistiksel anomali analizlerini kullanarak, normal görünen aktivitelerin arasına gizlenmiş sinsi saldırı izlerini (TTP) ortaya çıkarırlar. Bu süreç, sadece bir güvenlik operasyonu değil, aynı zamanda kurumun savunma kapasitesini sürekli iyileştiren bir öğrenme döngüsüdür.
Başarılı bir tehdit avcılığı operasyonu; geniş bir veri görünürlüğü, güçlü sorgu dilleri (KQL, SQL, SPL) ve saldırgan zihniyetine sahip yetkin analistler gerektirir. Manuel olarak keşfedilen her yeni tehdit deseni, otomatik tespit kurallarına dönüştürülerek savunma hattı güçlendirilir. Siber dünyada mutlak güvenlik yoktur; ancak sürekli avlanan, sorgulayan ve “temiz” raporlarına şüpheyle bakan bir ekip, en karmaşık APT (Gelişmiş Sürekli Tehdit) grupları için bile aşılması en zor engeldir.