Veri Sınıflandırma Taksonomileri: “Gizli / Kişisel / Özel Nitelikli” Etiketleme Motorlarının Teknik Kurulumu ve KVKK Uyumu
Dijital dünyada veri güvenliğinin ilk adımı, verinin hassasiyet seviyesini tanımlamaktır. Veri Sınıflandırma Taksonomisi, kurumsal verileri “Kamuya Açık”, “Gizli” veya KVKK özelinde “Kişisel” ve “Özel Nitelikli” gibi kategorilere ayıran hiyerarşik bir sistemdir. Etiketleme Motorları ise bu kategorileri dokümanlara ve e-postalara kalıcı birer metadata olarak işleyerek, verinin yaşam döngüsü boyunca güvenlik politikalarıyla (şifreleme, erişim kısıtlama vb.) birlikte hareket etmesini sağlar.
Teknik kurulumda sınıflandırma; kullanıcıların manuel seçimi, Regex tabanlı kural setleri veya makine öğrenmesi algoritmalarıyla gerçekleştirilir. Bu etiketler, Veri Kaybı Önleme (DLP) sistemleri için birer tetikleyici görevi görür. Örneğin; üzerinde “Özel Nitelikli” etiketi olan bir dosya harici bir belleğe kopyalanmak istendiğinde, sistem metadata alanını okuyarak işlemi anında engeller. Bu, insan hatasından kaynaklanan veri sızıntılarına karşı en güçlü teknik bariyerdir.
KVKK Madde 12 nezdinde sınıflandırma, “makul teknik tedbir” yükümlülüğünün temelidir. Bir ihlal durumunda kurumun sızan verinin niteliğini bildiğini ve ona uygun koruma katmanları (etiket tabanlı şifreleme vb.) yerleştirdiğini kanıtlaması, idari para cezalarının hafifletilmesinde kritik rol oynar. Sınıflandırılamayan veri, yönetilemeyen ve dolayısıyla korunamayan veridir; gerçek koruma verinin “kimlik kartına” (etiketine) uygun bir kalkan inşa etmekle mümkündür.
Toksik Varlıklar ve Mimari Zarafet: Veri Minimizasyonu Prensipleri
Siber güvenlikte Veri Minimizasyonu, bir sistemi korumak için en temel ve etkili yöntemdir: “Toplamadığın veriyi korumak zorunda kalmazsın.” KVKK Madde 4 ve GDPR Madde 5 uyarınca, kişisel verilerin sadece işleme amacıyla sınırlı ve ölçülü tutulması yasal bir zorunluluktur. Teknik dünyada bu; gereksiz her bir veri alanının (TCKN, doğum tarihi, tam konum vb.) sistem için birer “Toksik Varlık” (Data Toxicity) olarak görülmesi anlamına gelir.
Minimizasyon süreci üç kritik katmanda yönetilir: Ön Yüzde (UI/UX) dinamik formlar ve koşullu mantık kullanılarak sadece ihtiyaç anında veri toplanır. API Katmanında, “Over-fetching” (aşırı veri çekme) probleminden kaçınmak için GraphQL gibi teknolojilerle sadece talep edilen alanlar transfer edilir. Veritabanı Katmanında ise, işi biten verilerin (Örn: teslimat sonrası anlık konum) TTL (Time to Live) indeksleri ile otomatik olarak imha edilmesi sağlanır.
Bu yaklaşımın en büyük kazanımı, bir veri ihlali durumunda siber saldırının yaratacağı “Patlama Yarıçapını” (Blast Radius) daraltmasıdır. Eğer sistemde kritik ve gereksiz veriler stoklanmamışsa, sistem ele geçirilse bile sızan bilginin değeri minimumda kalır. Veri güvenliğinin en mutlak ve en ekonomik hali, mükemmel bir mimariyle çıkarılacak hiçbir veri kalmayana kadar sistemi sadeleştirmektir.
Görünmez Kalkan: Dinamik Veri Maskeleme (DDM) ve Sınırlandırılmış Gerçeklik
Kurumsal ekosistemlerde verinin hem işlenebilir olması hem de yetkisiz gözlerden korunması zorunluluğu, Dinamik Veri Maskeleme (DDM) teknolojisini doğurmuştur. DDM, veritabanındaki orijinal veriyi değiştirmeden, verinin kullanıcıya sunulduğu “gösterim katmanında” (presentation layer) devreye girer. Kullanıcının kimliğine, yetkisine ve bağlamına (zaman, cihaz, konum) göre veriyi anlık olarak maskeleyerek, kişinin sadece işini yapması için gereken kadarını görmesini sağlar.
Sistem, Tam Maskeleme, Kısmi Maskeleme (Örn: kredi kartının son 4 hanesi) ve Rastgele Değer Atama (Substitution) gibi algoritmalar kullanarak veriyi bulanıklaştırır. Bu proaktif yaklaşım, özellikle siber güvenlik dünyasının en büyük risklerinden biri olan İç Tehditleri (Insider Threats) engellemede hayati rol oynar; zira ekranında sadece yıldızlar (****) veya uydurma veriler gören bir çalışanın sızdırabileceği gerçek bir bilgi kalmamaktadır.
“Sıfır Güven” (Zero Trust) felsefesinin temel taşlarından biri olan DDM, veri sorumlularına KVKK nezdinde “veri minimizasyonu” ve “teknik tedbir” yükümlülüklerini yerine getirmede en teknolojik çözümü sunar. Veriyi taş duvarlar arkasına kilitlemek yerine, onu yetkili ellerde şeffaf, yetkisiz ellerde ise anlamsız kılan bu yöntem; kurumların veriden değer üretmesini engellemeden mahremiyeti koruyan modern bir görünmez kalkandır.
Veri Kalitesi ve KVKK “Doğruluk İlkesi”: Yanlış Kişisel Verinin Sistemde Kalmasının Hukuki Sonuçları
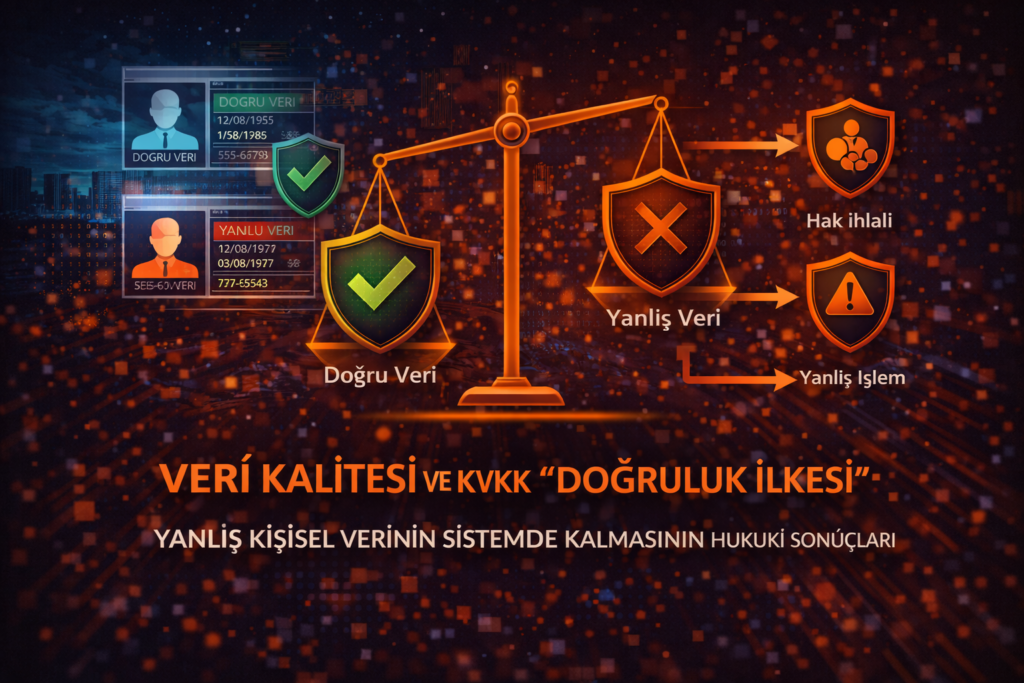
6698 Sayılı KVKK’nın 4. maddesi, kişisel verilerin işlenmesinde “doğru ve gerektiğinde güncel olma” ilkesini temel bir zorunluluk olarak belirler. Veri kalitesi; sadece verinin doğru formatta olması değil, gerçeği yansıtması ve zamanın gerisinde kalmamasıdır. Yanlış kişisel verilerin sistemlerde barındırılması, bireyler hakkında hatalı profilleme yapılmasına (kredi reddi, istihdam sorunları vb.) yol açarak kurumları ağır idari para cezaları ve tazminat davalarıyla karşı karşıya bırakır.
Teknik düzeyde veri doğruluğu; Input Validation (giriş kontrolü), Data Cleansing (veri temizleme) ve resmi servisler (MERNİS vb.) üzerinden yapılan Verification (doğrulama) süreçleriyle sağlanır. Master Data Management (MDM) sistemleri, kurum içindeki farklı departmanlarda dağılmış verileri tek bir “doğru kaynak” (Single Source of Truth) altında birleştirerek veri kirliliğini önler.
Hukuki açıdan, ilgili kişilerin (veri sahipleri) verilerini düzeltme hakkı saklıdır ve bu taleplerin 30 gün içinde yerine getirilmemesi doğrudan bir ihlal sebebidir. Kurumsal perspektifte doğruluk ilkesi, sadece yasal bir uyum değil, aynı zamanda itibar yönetimidir. Yanlış veri üzerine inşa edilen yapay zeka ve analiz modelleri, kurumu stratejik hatalara sürükler. Siber güvenlik ve mahremiyetin temeli, ancak saf ve doğru verilerle atılabilir.
Veri İşleme Envanteri (RoPA) Otomasyonu: KVKK Madde 16 Kapsamındaki Kayıt Yükümlülüğünün Teknik Araçlarla Yönetimi
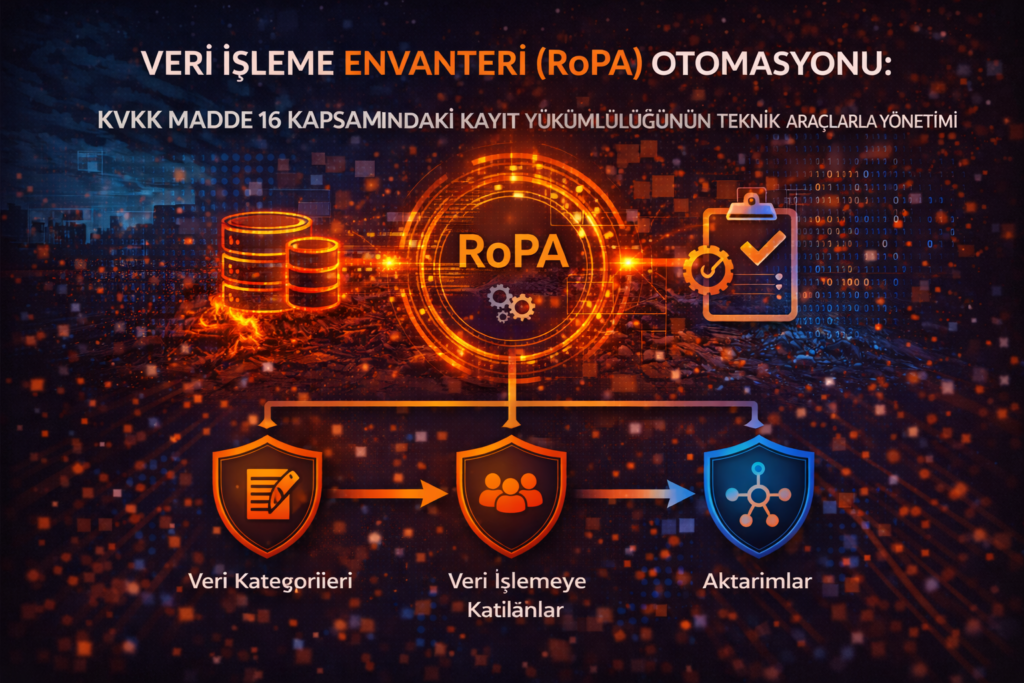
6698 Sayılı KVKK’nın 16. maddesi uyarınca veri sorumluları, işleme faaliyetlerini şeffaf ve hesap verebilir kılmak için bir Veri İşleme Envanteri (RoPA) tutmakla yükümlüdür. Manuel yöntemlerle (Excel vb.) yönetilmesi imkansız hale gelen bu dinamik süreç, günümüzde RoPA Otomasyonu ile teknik bir disipline kavuşturulmaktadır. Otomasyon araçları; ağdaki veritabanlarını ve bulut sistemlerini sürekli tarayarak (Data Discovery), kişisel verileri otomatik sınıflandırır ve verinin kurum içi yolculuğunu haritalandırır.
Teknik arka planda API’lar ve veritabanı bağlayıcıları (connectors) aracılığıyla çalışan bu sistemler, yeni bir veri alanı eklendiğinde veya bir uygulama devreye alındığında envanteri anlık olarak günceller. Bu proaktif yaklaşım, VERBİS beyanı ile fiili durum arasındaki tutarsızlıkları gidererek kurumları “yanıltıcı beyan” riskinden ve ağır idari para cezalarından korur. Ayrıca, saklama süresi dolan veriler için otomatik imha görevleri oluşturarak “ölçülülük” ilkesinin teknik sağlamasını yapar.
Kurumsal perspektifte RoPA otomasyonu, Gölge Veri İşleme (Shadow Data) faaliyetlerini görünür kılar ve siber güvenlik ile hukuk departmanları arasında teknik bir köprü kurar. Bir veri ihlali durumunda, güncel bir envantere sahip olmak, 72 saatlik yasal bildirim süresini verimli kullanmanın anahtarıdır. Dijital dönüşüm çağında hesap verebilirlik, kağıt üzerindeki beyanlarla değil, verinin her adımını anlık olarak izleyen ve raporlayan otomasyon sistemleriyle mümkündür.
Dijital Mezarlık: Veri İmha Politikası ve Geri Döndürülemez Silme Yöntemleri
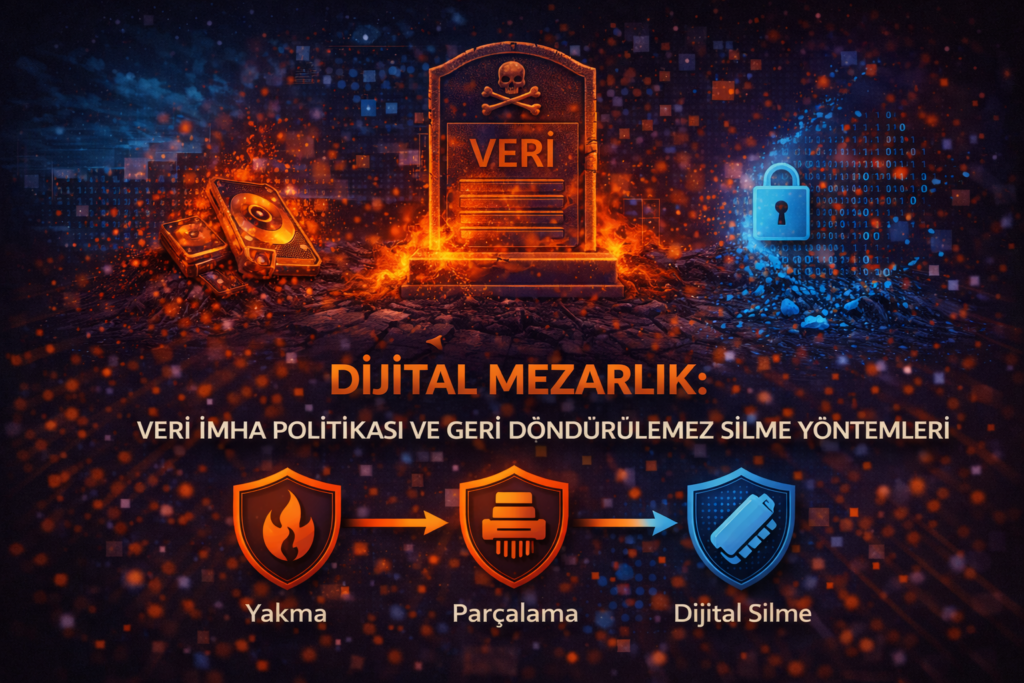
Siber güvenlikte bir veriyi korumak kadar, kullanım ömrü dolduğunda onu “geri döndürülemez” şekilde yok etmek de kritik bir sorumluluktur. İşletim sistemlerindeki standart “Sil” komutu veriyi diskten kazımaz; sadece yerini “yazılabilir” olarak işaretler. Gerçek bir veri imhası için donanımın türüne göre özel fiziksel ve yazılımsal yöntemler kullanılmalıdır.
Geleneksel sabit diskler (HDD) için en etkili yöntem olan Degaussing, devasa bir manyetik alan yaratarak veriyi fiziksel olarak buharlaştırır. Ancak bu yöntem mikroçip tabanlı SSD’lerde işe yaramaz; SSD’ler için Secure Erase komutuyla hücrelerin elektriksel olarak sıfırlanması gerekir. En yüksek gizlilik dereceli verilerde ise donanımın endüstriyel makinelerde toz haline getirilmesi olan Fiziksel Öğütme (Shredding) son çaredir.
KVKK Madde 7 ve ISO 27701 uyarınca, işleme amacı ortadan kalkan verilerin silinmesi, yok edilmesi veya anonim hale getirilmesi yasal bir zorunluluktur. Kurumlar, hangi donanımın hangi standartla (Örn: NIST 800-88) imha edileceğini belirleyen yazılı bir “Veri İmha Politikası” oluşturmalı ve her işlem sonrası “İmha Sertifikası” ile süreci kayıt altına almalıdır. Dijital dünyada gerçek güvenlik, verinin yaşam döngüsünü güvenli bir “ölüm” ile sonlandırabilmektir.
Veri Akış Diyagramları (DFD) ve KVKK Haritalama: Kişisel Verinin Kurum İçi Yolculuğunun Görselleştirilmesi
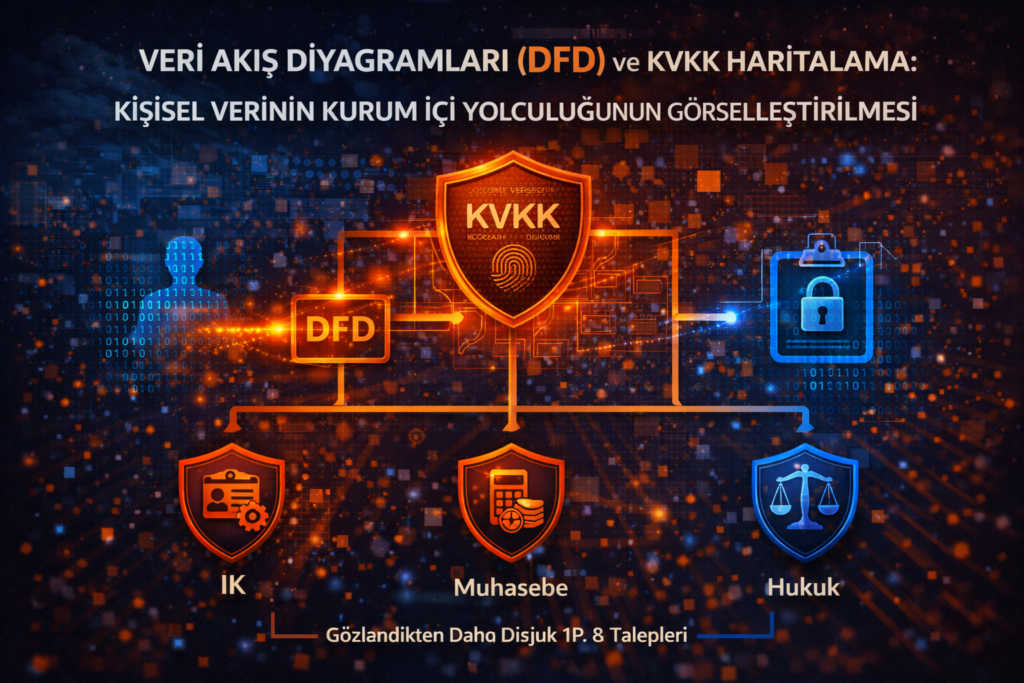
Siber güvenlik ve KVKK uyum sürecinin en kritik teknik ayağı, kişisel verilerin kurum içindeki yolculuğunu anlamaktır. Veri Akış Diyagramları (DFD); dış aktörleri, süreçleri, veri depolarını ve akış yönlerini görselleştirerek verinin yaşam döngüsünü somutlaştırır. Bir verinin kuruma giriş yaptığı andan imha edildiği ana kadar uğradığı her bir “durak”, KVKK Madde 4’teki “meşru amaçla işleme” ilkesinin teknik sağlamasını oluşturur.
DFD’lerin en büyük faydası, ana sistemlerin gölgesinde kalan Gölge IT (Shadow IT) yapılarını ve geçici depolama alanlarını (cache, log dosyaları) gün yüzüne çıkarmasıdır. Saldırganlar genellikle en güçlü korunan veritabanlarını değil, bu diyagramlarda unutulan “ara durakları” hedef alırlar. KVKK Madde 12 nezdinde, verinin izlediği yolu kağıt üzerinde göremeyen bir kurumun, o veriyi teknik olarak koruduğunu iddia etmesi mümkün değildir.
[Image illustrating the mapping of personal data flows within an organization for compliance]
Başarılı bir haritalama süreci; otomatik veri keşif araçları, trafik analizi ve süreç mülakatlarıyla desteklenmelidir. Diyagram üzerinde tespit edilen her bir zayıf nokta (şifrelenmemiş akışlar, gereksiz kopyalar), kurumun savunma stratejisini güçlendirmek için birer fırsattır. Dijital dünyada veri güvenliği, sadece kapıları kilitlemekle değil, verinin geçtiği her bir koridoru ve odayı haritalandırmakla başlar.
Tokenizasyon (Tokenization): Ödeme ve Kimlik Verilerinin Şifrelemeden Farklı Bir Yöntemle Korunması
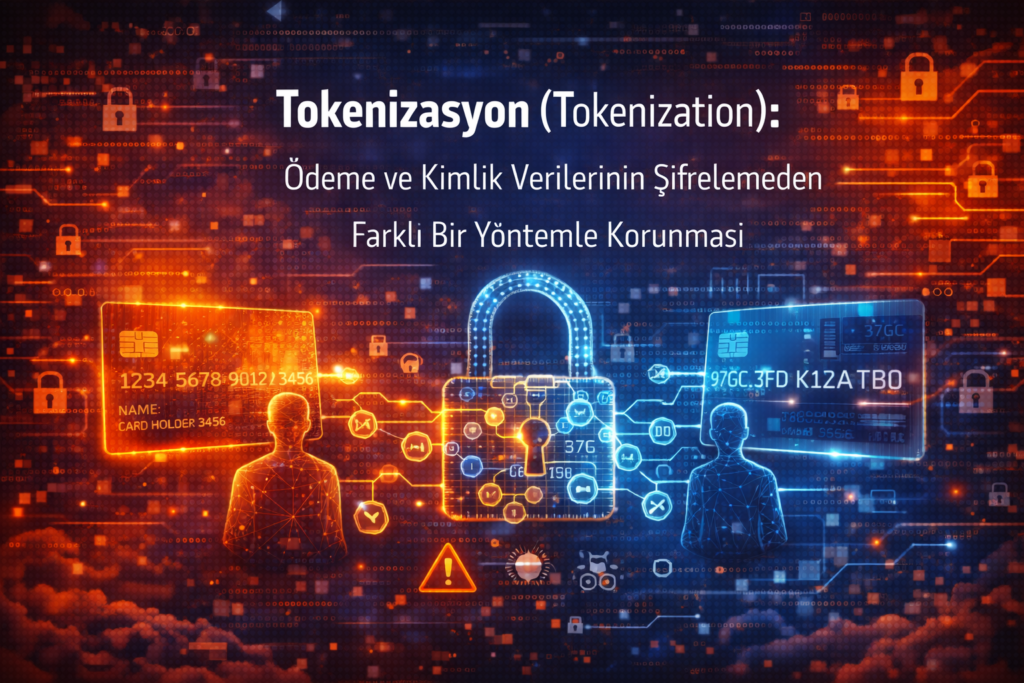
Dijital ekonomide hassas verilerin korunması için kullanılan Tokenizasyon, kredi kartı numarası veya T.C. Kimlik No gibi değerli bilgilerin, sistem içinde hiçbir matematiksel karşılığı olmayan rastgele bir “token” (simge) değeriyle değiştirilmesidir. Şifrelemeden farklı olarak, tokenizasyonda orijinal veriyi geri döndürecek bir “anahtar” bulunmaz; orijinal veri kurumun ana ağından izole, yüksek güvenlikli bir Token Kasası (Token Vault) içinde saklanır.
Teknik süreçte, verinin formatı korunarak (Format Preserving Tokenization) üretilen bu simgeler, CRM veya muhasebe gibi uygulama katmanlarında gerçek veriymiş gibi işlenebilir. Bu durum, bir siber saldırı sırasında saldırganın eline sadece “değersiz plastik pullar” geçmesini sağlar. Özellikle PCI-DSS uyumluluğu gereken finans kuruluşları için bu yöntem, gerçek verinin geçtiği sistem sayısını azalttığı için denetim maliyetlerini düşürür ve saldırı yüzeyini daraltır.
[Image comparing encryption versus tokenization workflows for data protection]
KVKK Madde 12 uyarınca tokenizasyon, “teknolojik imkanlar dahilindeki en üst düzey önlemlerden” biri kabul edilir. Bir veri ihlali durumunda, sızan veriler tokenlardan ibaretse, bu veriler “kişisel veri” niteliğini yitirdiği için yasal yaptırımlar hafifleyebilir. Ancak sistemin kalbi olan Token Kasası’nın güvenliği (HSM kullanımı, sıkı izolasyon ve erişim loglaması), tüm dijital ekosistemin güvenliğini belirleyen en kritik halkadır. Siber dünyada gerçek güvenlik, çalınacak bir verinin kalmamasıyla mümkündür.
Tehdit Modelleme (STRIDE/PASTA): Uygulama Geliştirme Aşamasında Kişisel Veri Risklerinin Sistematik Analizi
Siber güvenlikte bir uygulamayı korumanın en maliyet etkin yolu, zafiyetleri kod yazılmadan önce, tasarım aşamasında tespit etmektir. Tehdit Modelleme, bir sistemin mimarisini analiz ederek olası saldırı senaryolarını öngören sistematik bir süreçtir. Bu süreçte en yaygın kullanılan iki dev metodoloji; tehditleri kategorize eden (Spoofing, Tampering, Information Disclosure vb.) STRIDE ve saldırgan perspektifini iş riskleriyle birleştiren yedi aşamalı PASTA modelidir.
Tehdit modelleme, kişisel verilerin sisteme girişinden imhasına kadar olan tüm yolculuğunu Veri Akış Diyagramları (DFD) üzerinden takip eder. Bu sayede, bir kullanıcının verisinin hangi “Güven Sınırı” (Trust Boundary) geçişinde sızabileceği veya hangi işlem noktasında yetki yükseltme saldırısına maruz kalabileceği önceden saptanır. KVKK Madde 12 nezdinde bu proaktif yaklaşım, veri sorumlusunun “tasarım yoluyla veri koruma” yükümlülüğünü yerine getirdiğinin en güçlü teknik kanıtıdır.
[Image comparing STRIDE engineering focus versus PASTA business and risk-centric approach]
Kurumsal perspektifte tehdit modelleme, Güvenli Yazılım Geliştirme Yaşam Döngüsü (S-SDLC)’nin ayrılmaz bir parçasıdır. Microsoft Threat Modeling Tool gibi araçlarla desteklenen bu süreç, siber güvenlik risklerini soyut birer endişe olmaktan çıkarıp, somut mühendislik çözümlerine dönüştürür. Unutulmamalıdır ki; tasarım aşamasında öngörülmeyen bir mimari hata, sistem canlıya alındıktan sonra keşfedilirse düzeltilmesi on kat daha maliyetli ve riskli olacaktır.
Şatoya Alınan Truva Atı: Tedarikçi Risk Yönetimi ve SOC 2’nin Karanlık Labirentleri
Siber dünyada kurumlar, operasyonel hız kazanmak için kullandıkları bulut tabanlı servisler ve üçüncü taraf yazılımlar nedeniyle devasa bir Tedarik Zinciri (Supply Chain) riskine maruz kalmaktadır. Saldırganlar, ana hedefi vurmak yerine güvenlik duvarları daha zayıf olan tedarikçileri “Truva Atı” olarak kullanarak sisteme sızarlar. KVKK Madde 12 uyarınca, veriyi işleyen tedarikçi hacklense dahi hukuki sorumluluk asli olarak “Veri Sorumlusu” olan kurumdadır. Bu riski yönetmenin tek yolu, tedarikçileri bağımsız denetim raporları olan ISO 27001 ve özellikle SOC 2 standartlarına göre titizlikle sorgulamaktır.
SOC 2 denetimlerinde en kritik ayrım Type I ve Type II raporları arasındadır. Type I sadece sistemin tasarımını o anlık doğrular; asıl güvenceyi sunan Type II ise sistemin en az 6-12 aylık bir dönemdeki operasyonel başarısını (loglar, İK kayıtları, teknik kontroller) acımasızca test eder. Raporun en can alıcı bölümü olan CUEC (Tamamlayıcı Kullanıcı Kurum Kontrolleri), tedarikçinin güvenli kalabilmesi için müşteriye (size) yüklediği MFA kullanımı veya yetki yönetimi gibi “ev ödevlerini” içerir. Bu ödevlerin yapılmaması, bir ihlal durumunda sorumluluğun tamamen kuruma kalmasına neden olur.
Tedarikçi risk yönetimi, bir sözleşme imzalamakla biten statik bir süreç değil; SecurityScorecard gibi platformlarla yapılan sürekli izleme, periyodik sızma testleri ve güncel SOC 2 raporlarının analiziyle yürütülen dinamik bir operasyondur. Şatonun anahtarlarını dışarıya verirken, o anahtarı tutacak ellerin yetkinliğinden emin olmak, en az şatoyu inşa etmek kadar hayati bir güvenlik katmanıdır.