Veri Anonimleştirme Teknikleri: Mahremiyet ve Fayda Arasındaki Hassas Terazi

Veri Güvenliği

Veri, Yeni Petrol mü Yoksa Radyoaktif Atık mı?

21.yüzyılınen büyük klişesi “Veri yeni petroldür” sözüdür. Evet, veri işletmelere güç verir, yapay zekayı besler ve inovasyonu tetikler. Ancak veri, aynı zamanda “Radyoaktif Atık” gibidir. Eğer sızarsa, yanlış ellere geçerse veya kötü yönetilirse; şirketleri iflas ettirecek tazminatlara, itibar kaybına ve insanların hayatlarının mahvolmasına neden olabilir. GDPR (Avrupa) ve KVKK (Türkiye) gibi yasalar, bu radyoaktif maddeyi tutmak için kurşun kaplı odalar talep etmektedir. İşte Veri Anonimleştirme Teknikleri, verinin o tehlikeli (radyoaktif) özelliğini temizleyip, sadece faydalı (enerji veren) kısmını kullanmamızı sağlayan mühendislik sürecidir. 

Sektördeki en büyük yanılgı, bir Excel tablosundan “Ad-Soyad” sütununu silmenin anonimleştirme sanılmasıdır. Oysa ünlü “Netflix Ödülü” vakasında veya Massachusetts Valisi’nin sağlık verilerinin ifşasında görüldüğü gibi; doğum tarihi, posta kodu ve cinsiyet gibi masum görünen üç veri birleştiğinde, bir kişinin kimliğini %87 oranında tespit edebilirsiniz. Buna Yeniden Kimliklendirme (Reidentification) denir. Bu kapsamlı rehberde; veriyi körleştirmenin matematiksel yöntemlerini (k-Anonymity), veri kümelerine “Gürültü” (Noise) ekleyerek gizlilik sağlayan Diferansiyel Gizliliği ve gerçek veriye hiç dokunmadan üretilen Sentetik Veri teknolojilerini en ince teknik detayına kadar inceleyeceğiz. 

Kavramsal Karmaşa: Pseudonymization vs Anonymization

Hukuk ve teknik dünyasında bu iki terim arasındaki fark, gece ile gündüz gibidir. 

1. Takma Adlaştırma (Pseudonymization) 

Verinin, ek bir bilgi (Anahtar) olmadan kişiye ulaşılamayacak hale getirilmesidir. 

  • Yöntem: Ahmet Yılmaz ismini USER_12345 koduyla veya bir Hash değeriyle değiştirmek. 
  • Özellik: Geri Döndürülebilir (Reversible). Elinizde USER_12345 = Ahmet Yılmaz tablosu (Mapping Table) varsa, kimliği bulabilirsiniz. 
  • Hukuki Durum: GDPR ve KVKK’ya göre bu veri hala Kişisel Veridir. Sadece güvenliği artırılmıştır. 

2. Anonimleştirme (Anonymization) 

Verinin, başka verilerle eşleştirilse dahi kimliğin asla belirlenemeyecek hale getirilmesidir. 

  • Özellik: Geri Döndürülemez (Irreversible). Anonimleştirme işlemi yapıldıktan sonra, işlemi yapan kişi bile verinin kime ait olduğunu bulamaz.
  • Hukuki Durum: Bu veri artık Kişisel Veri Değildir. Yasaların kapsamından çıkar, özgürce işlenebilir ve paylaşılabilir.

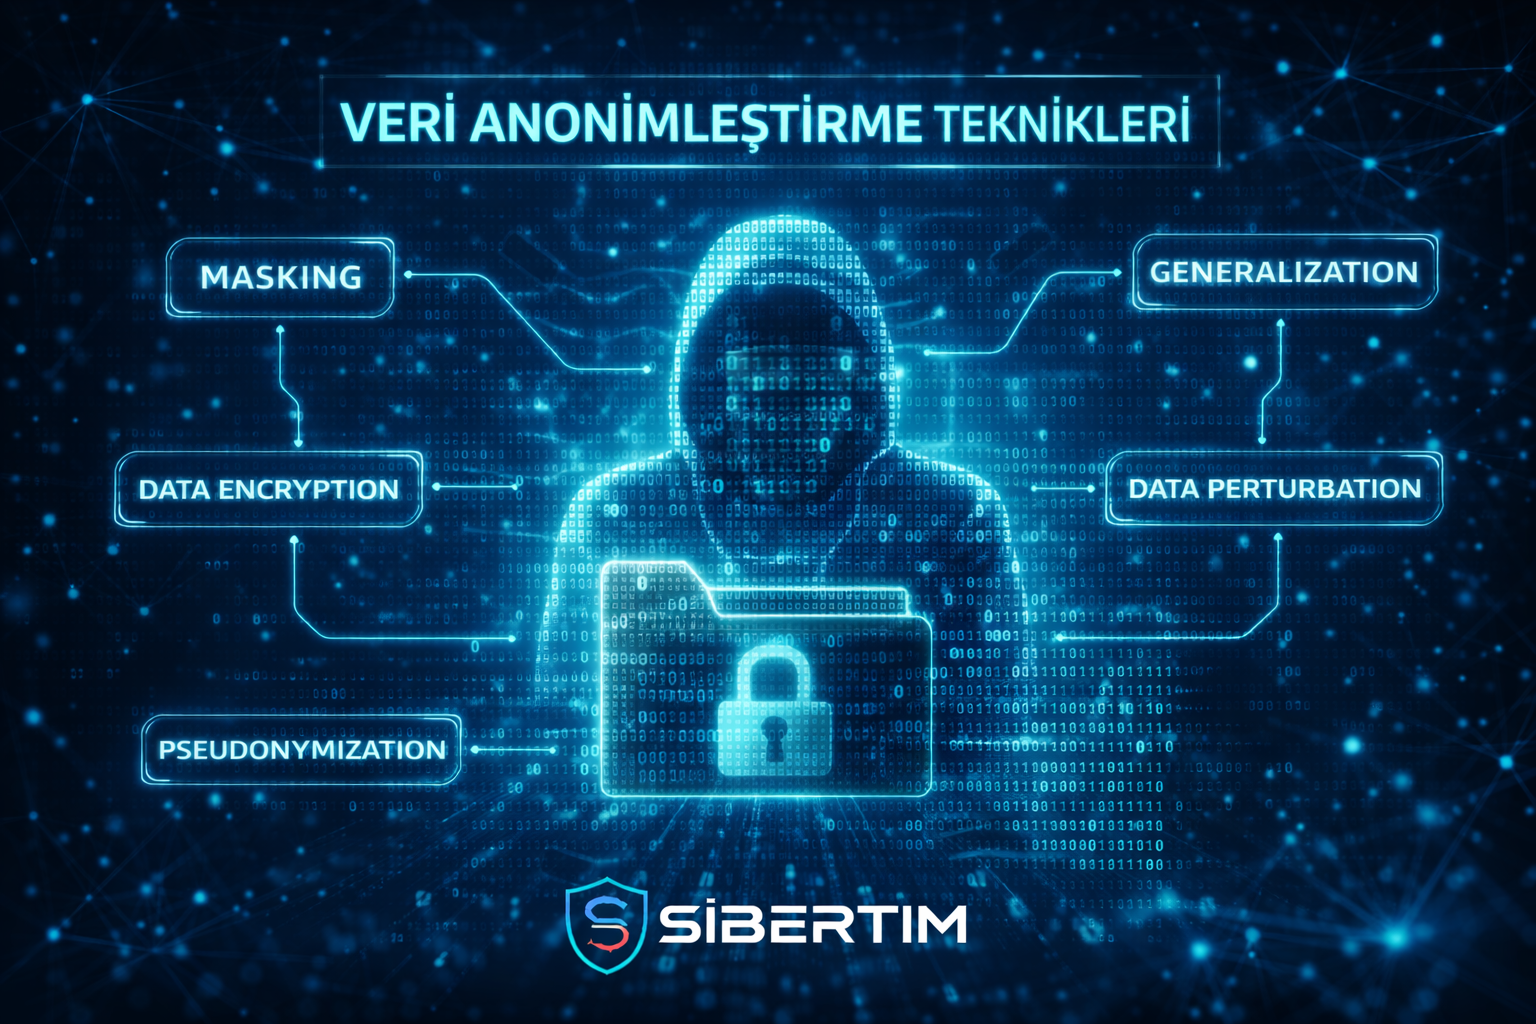
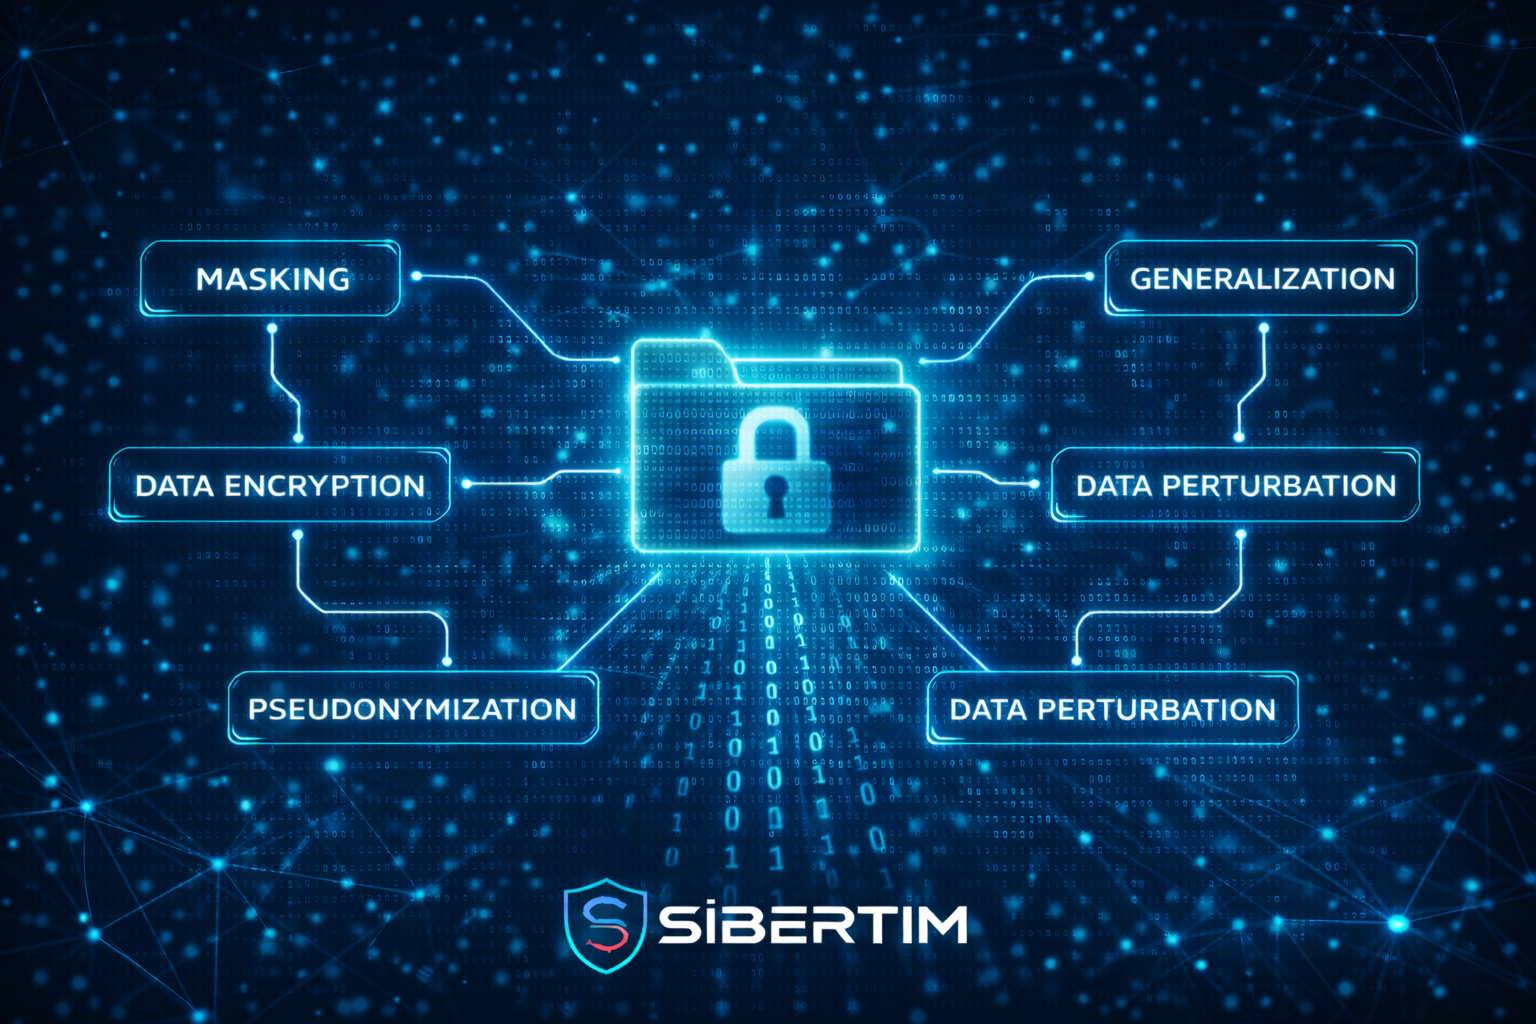
Temel Teknikler: Maskeleme ve Genelleştirme

Anonimleştirmenin en ilkel ama en yaygın kullanılan yapı taşlarıdır. 

Veri Maskeleme (Data Masking) 

Verinin yapısını bozmadan içeriğini gizlemektir. 

  • Karakter Karıştırma (Shuffling): Bir sütundaki harflerin yerini değiştirmek.
  • Nulling: Veriyi tamamen silip NULL yazmak. 
  • Yıldızlama: Kredi kartı numarasını 4543 **** **** 1234 şeklinde göstermek. 

Genelleştirme (Generalization) 

Veriyi daha az hassas bir formata dönüştürmektir. Amaç, veriyi “tekil” olmaktan çıkarıp bir “küme” içine saklamaktır. 

  • Yaş: 34 yerine 30-40 Arası yazmak. 
  • Konum: Kadıköy, Caferağa Mah. yerine sadece İstanbul yazmak. 
  • Zaman: 14.05.2024 14:32:15 yerine Mayıs 2024 yazmak. 

Bu yöntemler verinin faydasını (Utility) korur ama tek başlarına yeterli değildir. 
Mahremiyet Modelleri1: k-Anonymity (Kalabalıkta Gizlenmek)

Latanya Sweeney tarafından geliştirilen bu model, “Herkesin içinde kaybolma” prensibine dayanır. 

  • Tanım: Bir veri setindeki her kayıt, en az k-1 adet diğer kayıtla ayırt edilemez olmalıdır. 
  • Örnek (k=3): Bir tabloda Yaş: 30, Cinsiyet: Erkek, Posta Kodu: 34000 özelliklerine sahip bir satır varsa, aynı özelliklere sahip en az 2 kişi daha olmalıdır. 
  • Sonuç: Bir saldırgan tabloya baktığında, “Bu satır Ahmet’e ait” diyemez. Sadece “Bu satır Ahmet, Mehmet veya Ali’den birine ait” diyebilir.

Zafiyet: Homojenlik Saldırısı (Homogeneity Attack)

Eğer o 3 kişinin (Ahmet, Mehmet, Ali) üçünün de “Hastalık” sütununda “Kanser” yazıyorsa ne olur? 

Saldırgan Ahmet’in hangi satırda olduğunu bilmese bile, o grupta olduğunu bildiği için Ahmet’in Kanser olduğunu öğrenir. Gizlilik ifşa olur.

Mahremiyet Modelleri 2: l-Diversity (Çeşitlilik)

k-Anonymity’nin homojenlik açığını kapatmak için geliştirilmiştir. 

  • Tanım: Her bir eşdeğerlik sınıfında (k grubunda), hassas öznitelik (Hastalık gibi) en az l farklı değere sahip olmalıdır.
  • Uygulama: Grubumuzdaki 3 kişinin hastalıkları şöyle olmalıdır: Kanser, Grip, Kalp Krizi.
  • Sonuç: Saldırgan Ahmet’in grupta olduğunu bilse bile, hastalığının ne olduğunu %100 bilemez. İhtimali 1/3’e düşürürüz. 


Zafiyet: Benzerlik Saldırısı (Similarity Attack)

Eğer hastalıklar Mide Kanseri, Akciğer Kanseri ve Cilt Kanseri ise?

Saldırgan Ahmet’in tam hastalığını bilemez ama “Bir tür kanser” olduğunu anlar. Veya bir gruptaki hastalık dağılımı toplum genelinden çok farklıysa (Skewness Attack) yine bilgi sızar.

Mahremiyet Modelleri 3: t-Closeness (Dağılım Yakınlığı)

l-Diversity’nin eksiğini kapatan en gelişmiş modeldir. 

  • Tanım: Bir alt gruptaki hassas verilerin dağılımı, tüm veri setindeki (veya toplumdaki) genel dağılıma t kadar yakın olmalıdır. 
  • Mantık: Eğer toplumda kanser oranı %1 ise, oluşturduğunuz anonim grupta da kanser oranı %1’e yakın olmalıdır. Eğer grupta kanser oranı %50 ise, saldırgan bu gruptaki birinin kanser olma ihtimalinin yüksek olduğunu anlar. 
  • Bedel: t-Closeness uygulamak, verinin faydasını (Utility) ciddi oranda düşürür. Veri o kadar genelleştirilir ki, analiz yapmak zorlaşır.

Altın Standart: Diferansiyel Gizlilik (Differential Privacy)

Geleneksel yöntemler (k, l, t) veriyi yayınlamadan önce değiştirir. Diferansiyel Gizlilik ise, veriyi sorgularken matematiksel gürültü (Noise) ekler. Apple, Google ve Uber tarafından kullanılan modern standarttır. 

Nasıl Çalışır? (Epsilon Bütçesi) 

  • Senaryo: “Veri tabanında kaç kişi HIV pozitif?” sorusunu soruyorsunuz. 
  • İşlem: Sistem gerçek sayıyı (Örn: 100) bulur. Ancak size cevap vermeden önce, Laplace veya Gauss dağılımı kullanarak rastgele bir sayı (Gürültü) ekler. 
  • Cevap: Sistem size “102” veya “98” der. 
  • Garanti: Veri tabanında tek bir kişinin verisini silseniz veya ekleseniz bile, çıkan sonuç (gürültü yüzünden) neredeyse aynı kalır. 
  • Sonuç: Bir saldırgan, çıktılara bakarak tek bir bireyin veri tabanında olup olmadığını anlayamaz. 


Privacy Budget (Epsilon): Her sorguda biraz gürültü eklenir. Ancak aynı soruyu 1000 kere sorup ortalamasını alırsanız, gerçek sayıya ulaşırsınız. Bunu engellemek için her sorguda bir “Gizlilik Bütçesi” harcanır. Bütçe bittiğinde sistem sorguya kapanır.

Veri Faydası (Utility) vs. Veri Mahremiyeti (Privacy)

Anonimleştirmede sihirli bir değnek yoktur. Bir Takas (Trade-off) vardır.

  • Yüksek Mahremiyet: Veriyi tamamen siyah banda alırsanız %100 güvenlidir, ama hiçbir işe yaramaz (Fayda = 0). 
  • Yüksek Fayda: Veriyi ham haliyle verirseniz analiz mükemmel olur, ama herkes ifşa olur (Mahremiyet = 0). 

Veri bilimcisinin sanatı, bu grafikteki “Tatlı Nokta”yı (Sweet Spot) bulmaktır. Veriyi, analitik sonuçları bozmayacak kadar değiştirmek, ama kişileri ifşa etmeyecek kadar gizlemek gerekir.

Geleceğin Teknolojisi: Sentetik Veri (Synthetic Data)

Geleneksel yöntemler mevcut veriyi “bozarak” korur. Peki ya gerçek veriyi hiç kullanmasak? 

  1. Tanım: Yapay Zeka (GANs – Generative Adversarial Networks) kullanılarak, gerçek verinin istatistiksel özelliklerini taklit eden ama tamamen sahte (fake) kişilerden oluşan veri üretmektir. 
  2. Süreç: AI, gerçek hasta verilerini inceler. Yaş, hastalık, cinsiyet arasındaki korelasyonları öğrenir. Sonra “sıfırdan” 1 milyon adet hasta üretir. 
  3. Avantaj: 
    1. %100 Anonim: Üretilen “Ali Veli” diye biri gerçek dünyada yoktur. KVKK derdi yoktur. 
    2. Yüksek Fayda: Makine öğrenmesi modellerini eğitmek için gerçek veri kadar performanslıdır. 
  4. Kullanım: Finans sektöründe dolandırıcılık tespiti eğitimi, otonom araç sürüş verileri.

Saldırı Vektörleri: Veri Nasıl İfşa Olur?

Anonimleştirme neden başarısız olur? 

  1. Bağlantı Saldırısı (Linkage Attack): Anonim veri setini, halka açık başka bir veri setiyle (Seçmen listesi, LinkedIn profilleri) birleştirmek.  (Netflix Prize vakası).
  2. Çıkarım Saldırısı (Inference Attack): Veriden, hassas bilgiyi mantıksal olarak tahmin etmek. 
  3. Arka Plan Bilgisi: Saldırganın hedef hakkında önceden bazı bilgilere (Komşusu olması vb.) sahip olması.

Sıkça Sorulan Sorular (SSS)

1. Hashlenmiş (özetlenmiş) veri anonim midir?

  • Hayır, sadece “Pseudonymized” (takma adlaşmış) veridir. Rainbow Table saldırıları veya Brute Force (kaba kuvvet) ile hash kırılabilir ve orijinal veri (TCKN, telefon vb.) açığa çıkabilir.

2. En iyi anonimleştirme yöntemi hangisidir?

  • Tek bir “en iyi” yöntem yoktur. Seçim; verinin türüne (yapısal, metin, görüntü) ve kullanım amacına göre değişir. İstatistiksel çalışmalar için Diferansiyel Gizlilik (Differential Privacy), yazılım testleri için ise Sentetik Veri kullanımı oldukça etkilidir.

3. Anonim veriyi satabilir miyim?

  • Eğer veri gerçekten anonimleştirildiyse (yani geri döndürülemez haldeyse), evet. Bu durumda veri KVKK kapsamı dışına çıkar. Ancak anonimleştirmenin teknik imkanlarla bozulması riskine karşı sözleşmesel korumalar (cezai şartlar vb.) eklenmesi şarttır.

4. Veritabanını şifrelemek anonimleştirme midir?

  • Hayır. Şifreleme bir güvenlik önlemidir, anonimleştirme değildir. Şifreli verinin bir anahtarı (key) vardır ve bu anahtarla veri orijinal haline döndürülebilir. Anonim verinin ise geri dönüş anahtarı yoktur.

5. KVKK’ya göre hangi yöntemi kullanmalıyım?

  • KVKK’nın “Kişisel Verilerin Silinmesi, Yok Edilmesi veya Anonim Hale Getirilmesi Hakkında Yönetmelik” rehberi baz alınmalıdır. Kurumlar, kendi risk analizlerine göre k-anonymity, maskeleme veya gürültü ekleme gibi uygun tekniklerden birini veya birkaçını seçmelidir.
Tags :
Diferansiyel Gizlilik,kvkk,Veri Anonimleştirme,Veri Gizliliği
Share This :

Diğer Yazılar

Bize Soru Sorun

Soru ve görüşleriniz için bizimle iletişime geçebilirsiniz.